Si vous utilisez les réponses flash de Qwant, il se peut que vous ayez déjà croisé Olala mini. OVHcloud a présenté le 17 novembre ce premier modèle de langage de sa nouvelle famille Olala. L’annonce a quelque chose de concret : le moteur de recherche l’utilise déjà, et OVHcloud le destine aussi aux machines équipées d’une carte graphique de 8 Go.
Sept milliards de paramètres, un milliard sollicité
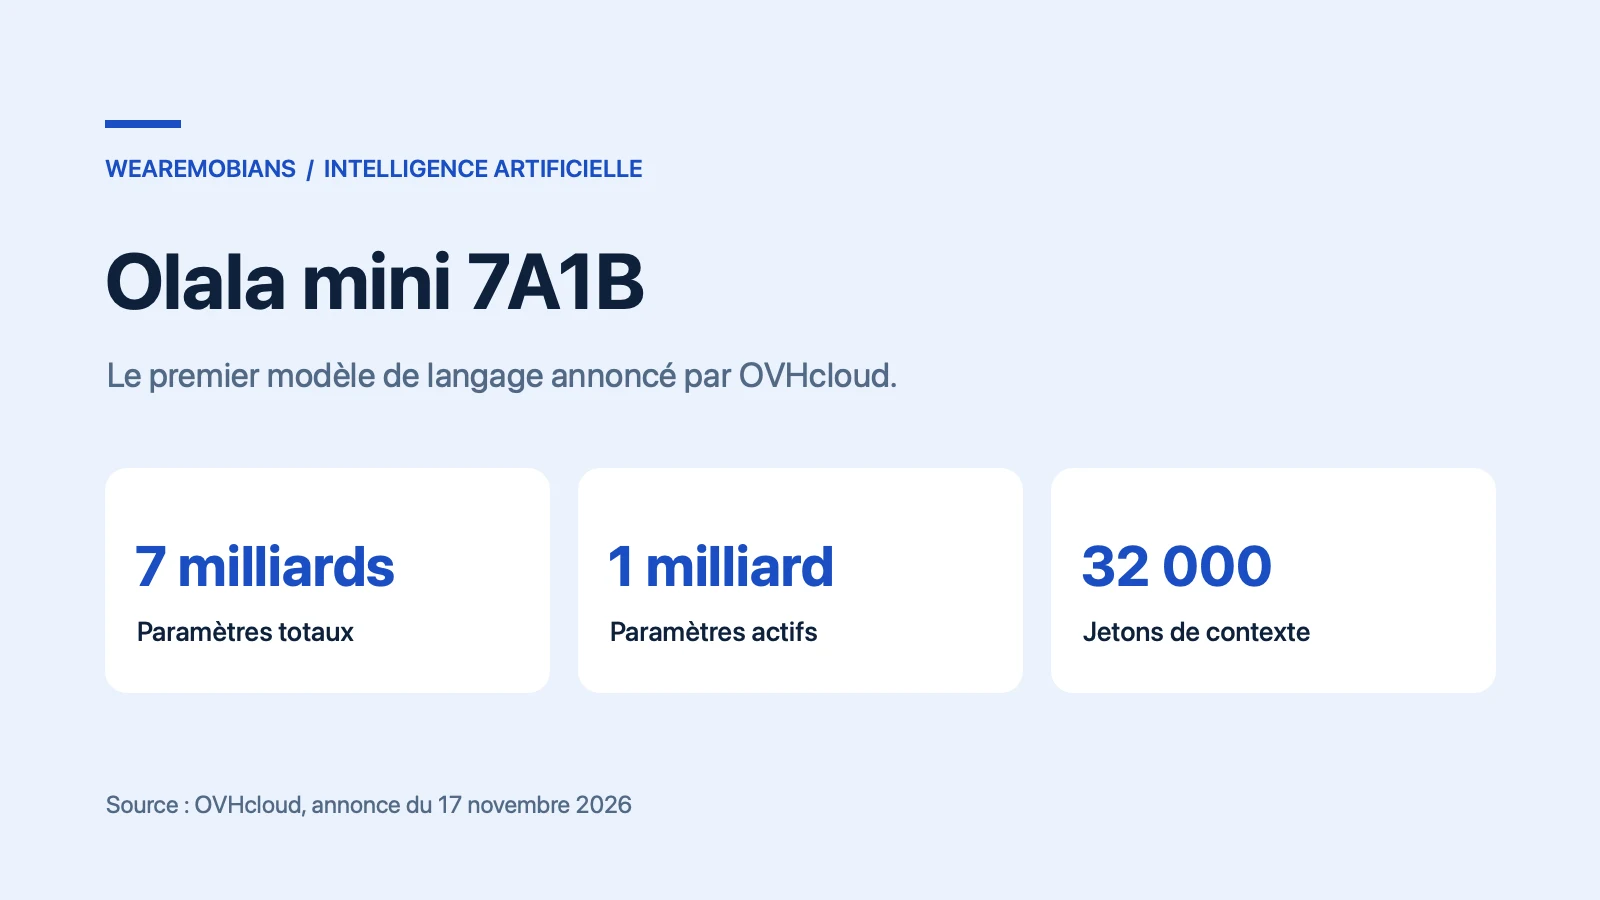
Olala mini 7A1B compte sept milliards de paramètres. Il n’en mobilise qu’environ un milliard à la fois, ce qui limite le calcul nécessaire pour produire une réponse. Sa fenêtre de contexte est de 32 000 jetons. OVHcloud annonce un fonctionnement sur GPU dès 8 Go de mémoire et indique avoir atteint 50 jetons par seconde sur un processeur classique. Ce débit est celui annoncé par le constructeur et dépend de la configuration utilisée.
Pour Qwant, le gain se joue dans les réponses flash
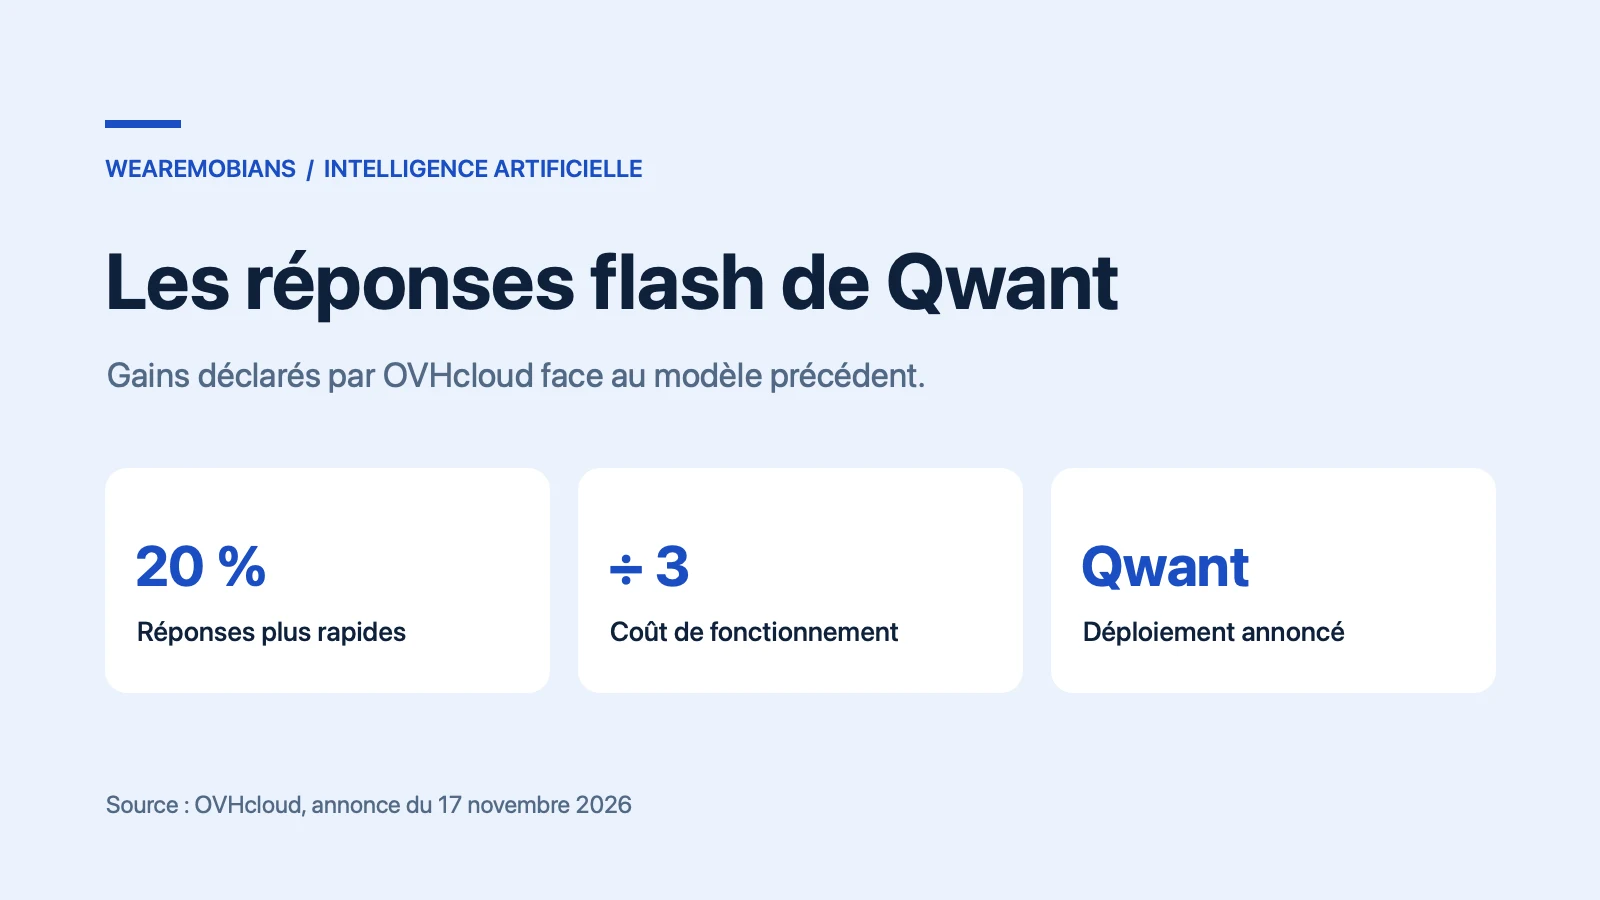
Le changement s’opère derrière le moteur de recherche. Les réponses flash utilisent déjà Olala mini. OVHcloud dit qu’elles arrivent 20 % plus vite et que leur coût de fonctionnement est divisé par trois par rapport au modèle précédent. Ces chiffres portent sur cet usage précis.
Des poids annoncés sous licence Apache 2.0
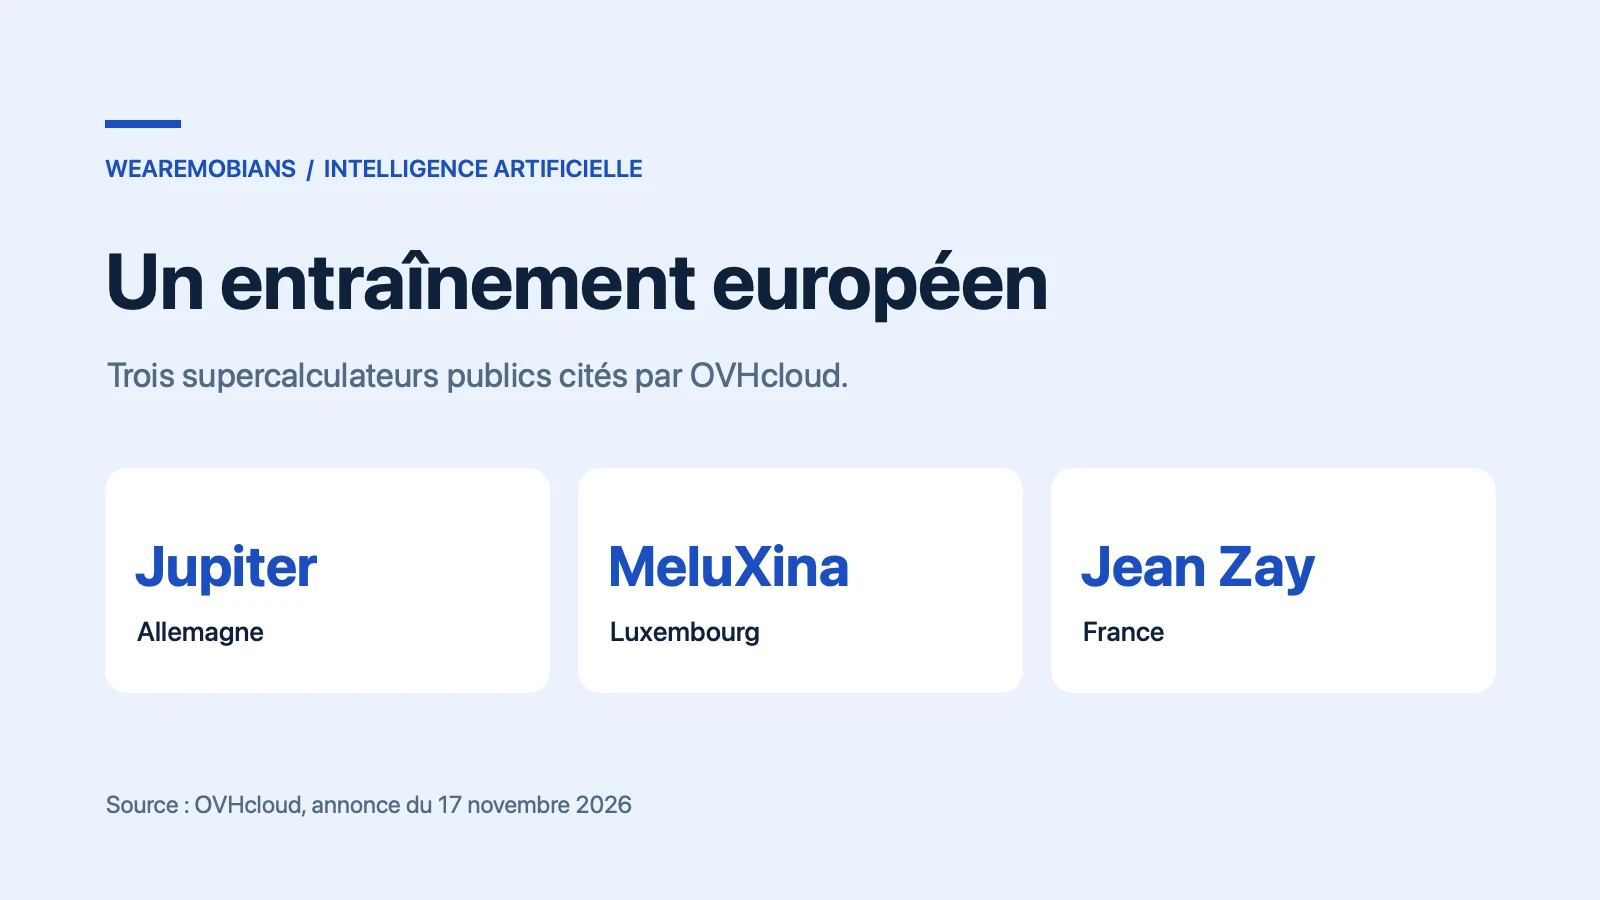
Le modèle a été entraîné sur les supercalculateurs européens Jupiter, MeluXina et Jean Zay. OVHcloud annonce une diffusion sur Hugging Face sous licence Apache 2.0, accompagnée du modèle de base, d’un rapport technique et d’une documentation liée à l’AI Act. Son lancement officiel est prévu le 19 novembre au sommet AI d’OVHcloud. La version suivante doit porter la fenêtre de contexte à 128 000 jetons d’ici à la fin de l’année, selon le calendrier annoncé.